

Agent AI to nie tajniak z filmu, tylko kawałek oprogramowania, który sam podejmuje decyzje. Otoczenie odczytuje przez sensory (strumienie danych, interfejsy, zapytania użytkowników), a wpływa na nie przez aktuatory (API, komendy, komunikaty), żeby osiągnąć cel. Trudność nie polega na tym, żeby takiego agenta napisać. Polega na tym, żeby wiedzieć, że nie ma jednego uniwersalnego agenta, i wybrać właściwy typ pod konkretny problem.
Ten jeden wybór, od najprostszego agenta reaktywnego po agenta zorientowanego na cel, odróżnia system, który trafia na produkcję, od dema, które po cichu gaśnie. Liczby to potwierdzają. Gartner prognozuje, że do końca 2027 roku ponad 40% projektów z agentami AI zostanie anulowanych z powodu problemów takich jak zła koordynacja agentów albo źle dobrany typ agenta. Z naszego doświadczenia projekty, które lądują w tych 40%, prawie nigdy nie rozbijają się o model. Rozbijają się o architekturę. W tym wpisie przechodzimy przez typy agentów, które nasi inżynierowie rozważają przy każdym projekcie, a potem pokazujemy, co naprawdę wnosi zespół, który podejmował takie decyzje na produkcji.
Czym jest framework PEAS i dlaczego od niego zaczynać?
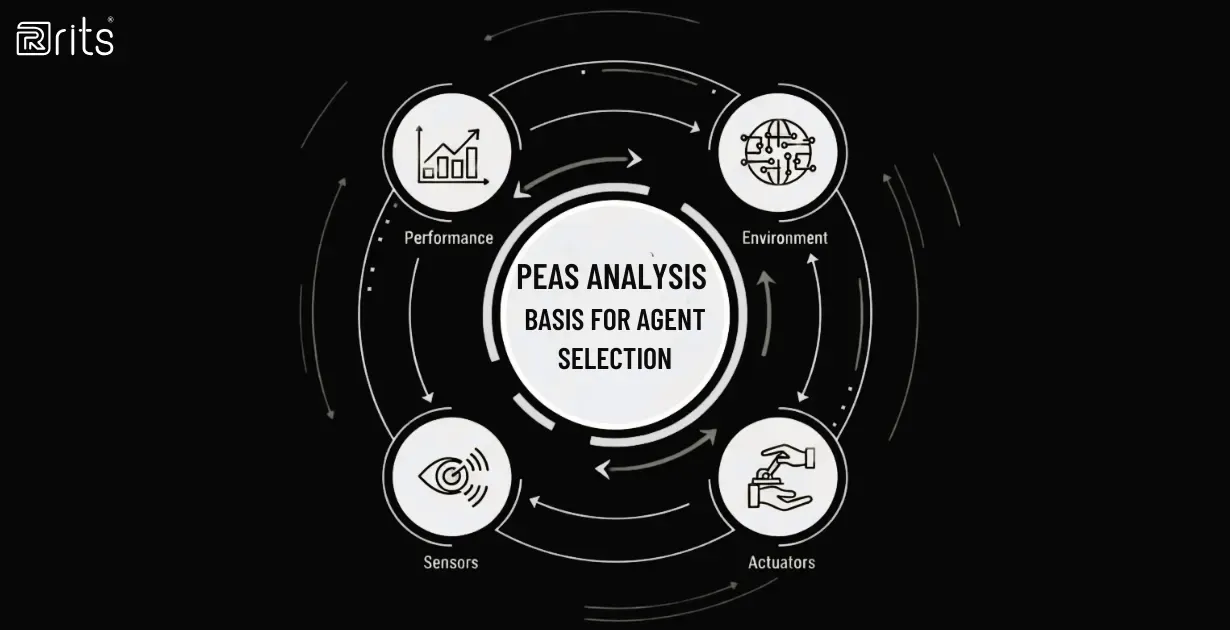
Zanim zaczniesz porównywać typy agentów, musisz precyzyjnie opisać problem. Używamy do tego PEAS, standardowego schematu opisu dowolnego agenta, bo wymusza pytania, które większość zespołów pomija:
- Performance (miara sukcesu): co tu naprawdę znaczy sukces? Maksymalizacja przychodu, minimalizacja błędów, czyste domknięcie zadania?
- Environment (środowisko): w jakim świecie działa agent? Czy jest w pełni obserwowalny, deterministyczny, statyczny, dyskretny? Odpowiedzi wyznaczają realną trudność zadania.
- Actuators (aktuatory): jak agent zmienia świat? Zapytania SQL, wywołania funkcji, ruchy silników.
- Sensors (sensory): jak postrzega świat? Dane wejściowe, strumienie z czujników, zapytania użytkowników, pliki logów.
Zdefiniowanie PEAS to pierwszy i najważniejszy krok, który w naturalny sposób prowadzi do właściwego typu agenta. Kto go pominie, buduje na piasku. W naszych projektach to właśnie tutaj doświadczony inżynier pokazuje swoją wartość, na długo zanim powstanie pierwsza linijka kodu spinającego agentów.
Jakie są trzy podstawowe typy agentów?
Agentów zwykle klasyfikuje się według złożoności wewnętrznej architektury i tego, jak dobrze rozumieją swój świat, a droga ta prowadzi od reaktywnych automatów do systemów, które planują i uczą się. Trzy typy wyznaczają na niej kamienie milowe. Zrozumienie ich mechaniki i ograniczeń jest kluczowe, bo nawet zaawansowane frameworki są dużo mniej niezawodne, niż sugeruje szum wokół nich. Świeży benchmark pokazał, że popularne rozwiązania poprawnie wykonują tylko około 50% zadań na zestawie 34 realistycznych problemów programistycznych. Wiele z tych porażek bierze się z jednego niedopasowania: surowa moc LLM wpięta w architekturę agenta źle dobraną do zadania.
Prosty agent reaktywny
Najbardziej podstawowy element. Działa wprost, według reguły „jeśli, to”: percepcja odpala warunek, warunek odpala akcję. Bez historii, bez modelu świata. JEŚLI czujnik temperatury pokazuje powyżej 22 stopni, TO wyłącz ogrzewanie, niezależnie od tego, jak pokój się do tej temperatury nagrzał.
Jego atuty to szybkość, prostota, przewidywalność i niskie wymagania obliczeniowe. Słabością jest ślepota na kontekst i na przeszłość. Umieść go w środowisku tylko częściowo obserwowalnym, gdzie sensory nie mówią całej prawdy, a okaże się bezradny. Nie potrafi też dążyć do stanu, który ma dopiero nastąpić. Sprawdza się w stabilnych, w pełni obserwowalnych środowiskach z czystą zależnością przyczynowo-skutkową: termostaty, proste filtry spamu, mechaniczne zabezpieczenia odcinające.
Agent reaktywny oparty na modelu
Kiedy środowisko nie jest w pełni widoczne, prosty agent się rozsypuje. Agent oparty na modelu dokłada brakujący element: wewnętrzny model świata, który zapisuje to, czego nie widać wprost. Ten model to reprezentacja tego, jak świat zmienia się w czasie i jak działania samego agenta go przesuwają.
Jego cykl rozbudowuje ten z prostego agenta: odbierz percepcję, zaktualizuj model świata, oceń stan bieżący względem modelu, zastosuj regułę, działaj. Model pozwala odróżnić identyczne percepcje po kontekście. Widząc zamknięte drzwi, agent wie, czy sam je zamknął, czy są zamknięte od dłuższego czasu. To moment pojawienia się stanu wewnętrznego i pamięci, realny krok w stronę elastycznego działania w niedoskonałych, fragmentarycznych środowiskach. Robot sprzątający, który mapuje pokój, żeby nie jeździć dwa razy po tym samym, korzysta z podstawowej wersji takiego modelu.
Agent zorientowany na cel
Agenci oparci na modelu wciąż reagują na teraźniejszość. Agenci zorientowani na cel używają modelu świata, żeby planować i symulować przyszłość względem zdefiniowanego celu, czyli opisu pożądanego stanu („paczka spakowana”, „klient dostał właściwą odpowiedź”). Akcja staje się środkiem, a nie celem.
Jego cykl: odbierz percepcję, zaktualizuj model, przeanalizuj cel, przeszukaj możliwe ścieżki, wybierz akcję. Agent symuluje sekwencje („co się stanie, jeśli zrobię A, a potem B?”) i wybiera ścieżkę, która jego zdaniem najbliżej doprowadzi do celu. Tak pojawia się pojęcie użyteczności, bo nie wszystkie ścieżki są równie dobre. To czyni go dużo bardziej elastycznym: ta sama architektura może realizować różne cele przez samą zmianę ich definicji, bez przepisywania reguł. Koszt jest jednak realny, i w mocy obliczeniowej potrzebnej do przeszukania przestrzeni stanów, i w dyscyplinie potrzebnej, żeby precyzyjnie zdefiniować cel i jego metryki sukcesu. Z naszego doświadczenia to właśnie tutaj złożone projekty, często budowane z zespołów agentów LLM, wpadają na problemy z koordynacją agentów i observability, te same, które tylu z nich blokują drogę na produkcję.
Czym są agenci oparci na użyteczności i uczący się?
Spektrum sięga dalej:
- Agenci oparci na użyteczności rozwijają typ zorientowany na cel. Kiedy do celu prowadzi kilka ścieżek, nie zadowalają się byle rozwiązaniem, tylko oceniają stany końcowe funkcją użyteczności i wybierają optymalny, co pozwala trafniej decydować w warunkach niepewności.
- Agenci uczący się dokładają pętlę uczenia do dowolnego z powyższych: krytyk ocenia działanie względem informacji zwrotnej, element uczący aktualizuje reguły, model albo funkcję użyteczności, a element eksplorujący próbuje nowych akcji w poszukiwaniu lepszych wyników. To fundament współczesnego uczenia maszynowego i głębokiego uczenia ze wzmocnieniem.
Gdzie ci agenci naprawdę działają?
Ta teoria materializuje się w systemach, z którymi mamy do czynienia codziennie:
- Prosty reaktywny: drzwi automatyczne, podstawowe regulatory PID, alerty w stylu „jeśli użycie CPU sięgnie 95%, wyślij mail”.
- Reaktywny oparty na modelu: większość NPC w grach (śledzą gracza, którego czasem tracą z oczu), prosta nawigacja uwzględniająca lokalizację.
- Zorientowany na cel i użyteczność: serce zaawansowanych systemów. Pojazdy autonomiczne (cel: bezpiecznie dojechać z A do B), silniki rekomendacji w e-commerce (cel: maksymalizacja oczekiwanej wartości zamówienia) oraz asystenci, którzy rozbijają złożone zapytanie na sekwencję kroków (cel: dostarczyć pełną odpowiedź). To w tych realizacjach opartych na LLM widać przepaść między prototypem a produkcją, tę samą, na którą wciąż wskazują benchmarki i Gartner.
Co nasze zespoły AI wnoszą do problemu tych 40%?
Znajomość typów to absolutne minimum. Przekucie ich w stabilny, obserwowalny i utrzymywalny system produkcyjny to już inna dyscyplina, i to ona decyduje, po której stronie 40% Gartnera wyląduje projekt. To codzienna robota naszych inżynierów AI:
- Architektura dobrana do PEAS. Nasi inżynierowie nie sięgają po agenta zorientowanego na cel i napędzanego LLM tylko dlatego, że to modne. Najpierw mapują PEAS, a potem wybierają najprostszy typ agenta, który spełnia wymagania, od reguły reaktywnej po pełnego plannera opartego na użyteczności. Przeinżynierowanie kładzie projekt równie skutecznie jak niedoinżynierowanie.
- Koordynacja, która wytrzymuje obciążenie. Awarie w projektach agentowych rzadko dotyczą pojedynczego agenta, biorą się z tego, jak agenci dogadują się między sobą. Projektujemy przekazania, guardraile i fallbacki, które trzymają wieloagentowe przepływy w ryzach, gdy uderza realny ruch.
- Observability od pierwszego dnia. Nie naprawisz tego, czego nie widzisz. Wbudowujemy tracing, ewaluację i monitoring w cały cykl życia agenta, żeby jego zachowanie pozostało czytelne, a nie zamieniło się w czarną skrzynkę w chwili wdrożenia.
- Wzorce produkcyjne przerobione na własnej skórze. Retry, kontrola kosztów, ugruntowanie odpowiedzi w źródłach, przegląd człowieka we właściwych punktach. To wzorce, które odróżniają przekonujące demo od systemu, który firma z sektora regulowanego może faktycznie utrzymać, a mamy je, bo je dowieźliśmy.
To także miejsce, w którym AI zmienia kształt zespołu, a nie dostawcy. Niewielka, doświadczona grupa naszych inżynierów, wsparta agentami AI biorącymi na siebie ilość, dostarcza tyle, ile dużo większy klasyczny zespół, i to szybciej, bo ludzie w pętli z góry wiedzą, która architektura przetrwa zderzenie z produkcją.
Jak wnieść tę zdolność do siebie?
Najszybsza droga, żeby nie wpaść w te 40%, to nie kolejna ewaluacja frameworka, tylko ludzie, którzy takie decyzje już podejmowali. Wpinamy się na dwa sposoby:
- Dedykowany zespół AI, który bierze na siebie projekt agentowy od początku do końca, od PEAS przez koordynację agentów i observability aż po produkcję.
- Staff augmentation, czyli doświadczony inżynier ML lub AI dostawiony do Twojego zespołu, żeby podejmował decyzje architektoniczne utrzymujące projekt w stanie zdatnym do wdrożenia.
Wybór właściwego typu agenta to nie ćwiczenie akademickie. To decyzja inżynierska, która najmocniej waży na tym, czy projekt kiedykolwiek dojedzie na produkcję. Jeśli wolisz uczyć się na projektach, które już dowieźliśmy, niż na tych z 40% Gartnera, to właśnie oferują nasze zespoły.
Wprowadź zespół ekspertów wspierany przez AI → Wzmocnienie zespołu