

Los asistentes de IA empresariales han pasado de ser pilotos experimentales a infraestructura esencial en servicios financieros, sanidad, industria y servicios profesionales. No son chatbots de consumo. Manejan datos sensibles, se integran con sistemas core, cumplen requisitos de compliance y escalan a miles de usuarios. El mercado es real, se espera que supere los 200.000 millones de dólares en 2030, con los asistentes entre los segmentos de mayor crecimiento.
Pero, según nuestra experiencia, la cifra de mercado no es lo interesante. Lo interesante es que la mayoría de estos proyectos fracasa o se estanca por el mismo motivo: la distancia entre una demo convincente y un sistema que un negocio regulado puede realmente operar es una cuestión de criterio de ingeniería, no de selección de modelo. Ese criterio reside en las personas. Este artículo es menos una guía de compra y más un relato directo de lo que nuestro equipo construyó para UNIQA, una de las mayores aseguradoras de Polonia, y de las competencias que hay detrás, porque el caso es la prueba más clara que podemos ofrecer de lo que hacen nuestros ingenieros.
¿Qué separa a producción de un prototipo?
Unos cuantos fundamentos técnicos deciden si un asistente se sostiene en un entorno regulado. Nuestros equipos tratan cada uno de ellos como una competencia que hay que ejecutar bien, no como una casilla que marcar.
LLM más generación aumentada por recuperación (RAG). El modelo de lenguaje se encarga del razonamiento y la generación; el RAG lo conecta con tu base de conocimiento en tiempo real. Los documentos internos, las políticas y las bases de datos viven en un vector store, y cuando un usuario pregunta algo, el sistema recupera el contenido relevante y se lo entrega al modelo como contexto. Las respuestas se fundamentan en tus datos en lugar de en el preentrenamiento del modelo, lo que reduce las alucinaciones y mantiene las respuestas actualizadas sin reentrenamiento constante. En nuestra opinión, la calidad del pipeline de RAG importa tanto como el propio modelo: un recuperador débil produce respuestas genéricas por muy bueno que sea el LLM.
Ejecución agéntica en varios pasos. El paso más allá de la conversación es un asistente que actúa: redacta, actualiza registros, dispara flujos de aprobación, consulta bases de datos dentro de un mismo intercambio. Esto se apoya en un uso disciplinado de herramientas, y los criterios que importan son la fiabilidad, la auditabilidad de cada acción y la profundidad de las integraciones nativas.
Seguridad, compliance y residencia de datos. Para los datos regulados esto es tan importante como la funcionalidad. El aislamiento de datos mantiene tu contenido fuera del entrenamiento compartido y de otros tenants. El control de acceso basado en roles limita las respuestas a los usuarios autorizados. La residencia de datos mantiene el procesamiento dentro de la geografía exigida. El despliegue on-premise o en cloud privada, el registro de auditoría y la alineación con marcos como el RGPD, SOC 2 o SR 11-7 para el riesgo de modelos son condiciones de entrada en banca, seguros y sanidad, no extras.
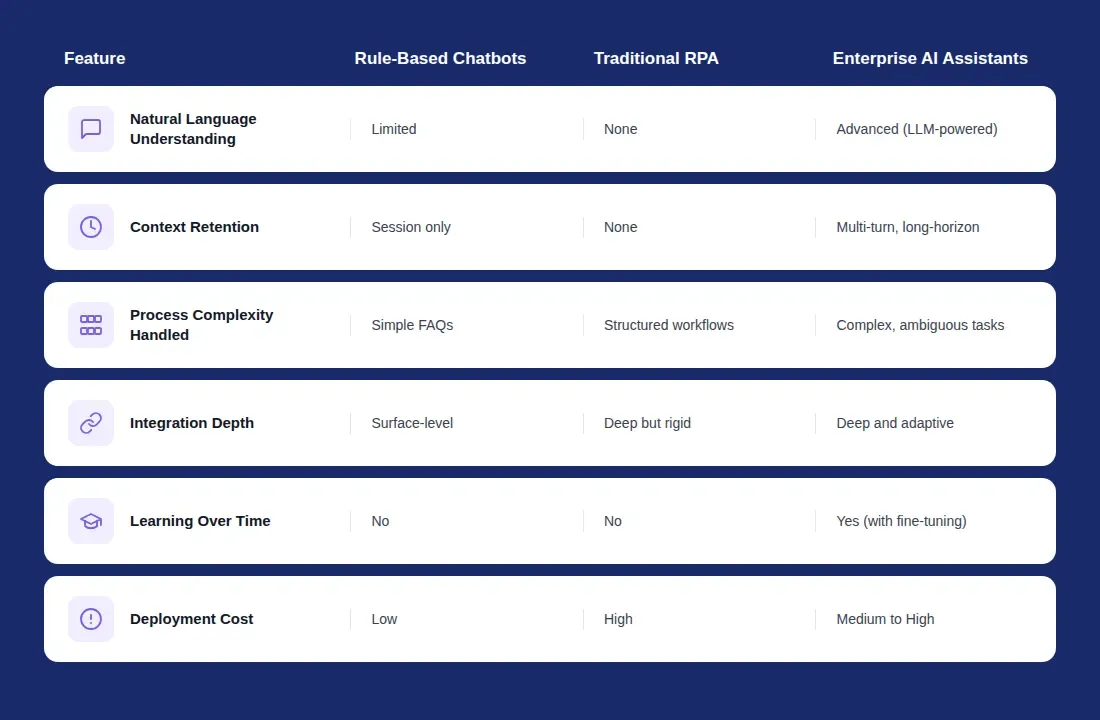
Un asistente funciona mejor como capa de coordinación por encima de los chatbots y el RPA existentes, decidiendo cuándo disparar la automatización, cuándo escalar a una persona y cuándo resolver una solicitud en conversación, en lugar de reemplazar a ninguna herramienta concreta. Y la mayor parte del coste de despliegue reside en la integración y la gestión del cambio, no en la licencia de la plataforma, que es precisamente el motivo por el que el equipo que hace el trabajo importa más que la insignia del software.
¿Qué necesitaba UNIQA?
UNIQA se enfrentaba al dolor operativo típico de una gran aseguradora regulada. Sus agentes y consultores trabajaban contra una biblioteca enorme y en constante actualización de Condiciones Generales de Seguro (documentos OWU), tarifas de productos y procedimientos internos. El puro volumen hacía casi imposible un acceso rápido y fiable con la búsqueda convencional, y eso provocaba cuatro problemas costosos:
- Baja capacidad de búsqueda, de modo que a los agentes les costaba encontrar rápido la cláusula o la disposición correcta.
- Tiempo medio de gestión (AHT) elevado, porque los consultores dedicaban tiempo real a buscar respuestas manualmente.
- Respuestas inconsistentes entre canales, con el call center, el equipo de correo y el chatbot dando a veces respuestas distintas a la misma pregunta.
- Onboarding lento y caro, sin una forma eficiente de formar a nuevos agentes en una cartera de productos compleja.
¿Qué construyó nuestro equipo?
Nuestro equipo entregó un panel de asistente inteligente integrado directamente en la interfaz existente del agente, construido sobre una arquitectura RAG que utiliza PLLuM, un foundation model optimizado para el polaco. Fue una decisión deliberada: los modelos multilingües genéricos pierden precisión con el lenguaje asegurador polaco, y en un entorno regulado esa pérdida es inaceptable. La elección refleja el tipo de decisión que nuestros ingenieros toman de forma rutinaria: ajustar el modelo al dominio en lugar de recurrir por defecto al nombre más grande.
La construcción abordó los cuatro problemas a la vez:
- Un panel de sugerencias de IA hace aflorar respuestas verificadas y listas para usar durante las interacciones en vivo con el cliente, eliminando las búsquedas manuales de documentos y reduciendo el AHT.
- La resumización automática convierte las densas disposiciones legales de los OWU en un lenguaje claro y orientado al cliente, recortando el tiempo de gestión y el riesgo de mala interpretación.
- La integración con el CRM y las plataformas de call center existentes creó una única fuente de verdad, de modo que las respuestas se mantienen consistentes en cada canal.
Por seguridad, la solución se desplegó on-premise en lugar de en una cloud pública, cumpliendo los requisitos para los datos sensibles de pólizas y clientes. Y la arquitectura RAG se configuró para un control estricto de las alucinaciones, de modo que cada respuesta se fundamenta en la documentación recuperada en lugar de en conjeturas del modelo.
¿Qué competencias había detrás?
Lee la construcción al revés y podrás ver exactamente qué aporta nuestro equipo a un proyecto de IA regulado:
- Trabajo con un foundation model en polaco (PLLuM) donde la precisión en el lenguaje legal y asegurador polaco es innegociable.
- RAG con control estricto de alucinaciones, la disciplina que convierte un chatbot plausible en un sistema que los reguladores y los responsables de riesgo aprobarán.
- Delivery on-premise en un sector regulado, que elimina una de las barreras de aprovisionamiento más habituales en lugar de discutir a su alrededor.
- Integración profunda en sistemas de CRM y contact center en vivo, para que el asistente actúe dentro de los flujos de trabajo existentes en lugar de junto a ellos.
¿Cómo lo entregó el equipo?
Nada de esto viene de una herramienta; viene de un equipo dedicado con la seniority adecuada trabajando de forma disciplinada y por fases. El despliegue se escalonó deliberadamente para gestionar el riesgo y demostrar resultados antes de escalar: las dos primeras semanas en auditoría de procesos y descubrimiento, mapeando flujos de trabajo y encontrando los puntos de partida de alto impacto; de la semana tres a la seis en integración de datos, preparación de la base de conocimiento e infraestructura de RAG; las semanas siete y ocho en calibración del modelo y un piloto controlado con agentes seleccionados; después despliegue completo y optimización de KPI. Empieza con foco, valida con usuarios reales y luego escala, dejando que la adopción se construya de forma incremental en lugar de soltar un sistema nuevo sobre toda la red de agentes de golpe.
En palabras de la propia UNIQA, el asistente es “un paso estratégico hacia una atención al cliente moderna”, una herramienta que apoya a los empleados en tiempo real con conocimiento preciso y verificado y, sobre todo, una mejora tangible de los estándares del seguro, donde la información precisa construye la confianza del cliente.
¿Qué significa esto para los sectores regulados?
Para aseguradoras, bancos, proveedores sanitarios y otras organizaciones reguladas, el proyecto de UNIQA deja claro un punto concreto: los modelos de lenguaje específicos de dominio, un grounding estricto con RAG, un despliegue seguro y una integración profunda entregan resultados que las herramientas de IA genéricas no pueden. Pero el punto más de fondo es que los cuatro son decisiones de ejecución tomadas por personas con experiencia. El asistente nunca es mejor que el equipo que diseña su recuperación, fija sus umbrales de grounding y lo conecta con tus sistemas.
Aquí es también donde la IA remodela el equipo en lugar de la oferta. Un grupo pequeño y senior de nuestros ingenieros, potenciado por herramientas de IA que gestionan el volumen, entrega lo que entregaría un equipo clásico mucho mayor, y más rápido, porque las personas en el bucle ya saben qué decisiones sobreviven a una auditoría.
¿Cómo incorporas a este equipo?
Si operas en seguros, banca, sanidad o cualquier sector regulado y quieres trabajo de RAG y LLM que pase el compliance a la primera, el camino más rápido no es montar la capacidad desde cero. Es incorporar un equipo que ya lo ha hecho. Nos enchufamos como un equipo dedicado que asume la construcción de un asistente de principio a fin, o mediante staff augmentation cuando necesitas ingenieros senior de RAG y LLM dentro de tu equipo existente.
El caso de UNIQA no es una afirmación sobre un producto. Es un registro de lo que entregó nuestra gente. Esa es la capacidad que está sobre la mesa.
FAQ
¿Cómo evita un asistente de IA empresarial las alucinaciones y se mantiene factualmente preciso? El método principal es la generación aumentada por recuperación: el sistema recupera documentos relevantes de una base de conocimiento verificada y los usa como base de su respuesta, en lugar de apoyarse en el preentrenamiento del modelo. Los sistemas eficaces añaden umbrales de confianza, de modo que cuando el contenido recuperado no respalda claramente una respuesta, el asistente señala la incertidumbre o escala a una persona. En nuestra construcción para UNIQA usamos controles estrictos de RAG para cumplir los estándares de precisión que los seguros exigen, donde una respuesta equivocada acarrea consecuencias financieras y regulatorias.
¿Cómo es un cronograma de implementación realista? Depende de la complejidad del caso de uso, del estado de tus activos de conocimiento y de las necesidades de integración. Un despliegue enfocado para un departamento con una base de conocimiento bien organizada puede llegar a piloto en seis a ocho semanas, como mostró la hoja de ruta de UNIQA. Los despliegues más amplios en varias funciones suelen durar de tres a seis meses desde la definición del alcance hasta producción. Según nuestra experiencia, el mejor predictor del cronograma es lo lista que esté la base de conocimiento, así que reserva tiempo para la gestión del cambio y la adopción junto al trabajo técnico.
¿Cómo se gestionan los datos sensibles y el compliance? Mediante el aislamiento de tenants que mantiene tus datos separados y fuera del entrenamiento compartido, el control de acceso basado en roles que refleja tus permisos existentes y el registro de auditoría de consultas y respuestas. Donde la residencia de datos es estricta, el despliegue on-premise o en cloud privada mantiene el procesamiento dentro de los límites exigidos, que es exactamente el camino que tomamos para UNIQA. En los sectores regulados esto se refuerza con cobertura contractual como los acuerdos de tratamiento de datos del RGPD y la certificación SOC 2.
¿Cómo deberíamos medir el ROI? Usa métricas operativas existentes, no ganancias de productividad estimadas. En los contact centers, sigue el tiempo medio de gestión, la resolución en el primer contacto y las consultas resueltas sin escalado. En la gestión del conocimiento, compara el tiempo hasta la respuesta antes y después y vigila la reducción de preguntas repetidas a los expertos. Fija líneas base antes del lanzamiento, revisa a los 30, 60 y 90 días y monitoriza la adopción, porque un asistente sin uso no aporta ningún retorno por muy alta que sea su precisión técnica.
Incorpora un equipo de expertos, potenciado por IA → /services/team-augmentation