

Enterprise-AI-Assistenten haben sich von experimentellen Piloten zu unverzichtbarer Infrastruktur entwickelt, quer durch Finanzdienstleistungen, Gesundheitswesen, Fertigung und professionelle Dienstleistungen. Sie sind keine Consumer-Chatbots. Sie verarbeiten sensible Daten, integrieren sich in Kernsysteme, erfüllen Compliance-Anforderungen und skalieren auf Tausende von Nutzern. Der Markt ist real, er soll bis 2030 die 200-Milliarden-Dollar-Marke überschreiten, wobei Assistenten zu den am schnellsten wachsenden Segmenten gehören.
Aber nach unserer Erfahrung ist die Marktzahl nicht der interessante Teil. Der interessante Teil ist, dass die meisten dieser Projekte aus demselben Grund scheitern oder stecken bleiben: Die Lücke zwischen einer überzeugenden Demo und einem System, das ein reguliertes Unternehmen tatsächlich betreiben kann, ist eine Frage des Engineering-Urteils, nicht der Modellauswahl. Dieses Urteil sitzt in Menschen. Dieser Artikel ist weniger ein Einkaufsratgeber als ein nüchterner Bericht darüber, was unser Team für UNIQA gebaut hat, einen der größten Versicherer Polens, und über die Kompetenzen dahinter, denn dieser Fall ist der klarste Beleg, den wir dafür anbieten können, was unsere Engineers tun.
Was trennt Produktion von einem Prototyp?
Ein paar technische Grundlagen entscheiden, ob ein Assistent in einem regulierten Umfeld standhält. Unsere Teams behandeln jede von ihnen als Kompetenz, die man richtig hinbekommen muss, nicht als Häkchen auf einer Liste.
LLM plus Retrieval-Augmented Generation (RAG). Das Sprachmodell übernimmt Reasoning und Generierung; RAG verbindet es in Echtzeit mit Ihrer Wissensbasis. Interne Dokumente, Richtlinien und Datenbanken liegen in einem Vektorspeicher, und wenn ein Nutzer etwas fragt, ruft das System die relevanten Inhalte ab und übergibt sie dem Modell als Kontext. Antworten sind in Ihren Daten verankert statt im Vortraining des Modells, was Halluzinationen reduziert und Antworten aktuell hält, ohne ständiges Nachtrainieren. Aus unserer Sicht zählt die Qualität der RAG-Pipeline genauso viel wie das Modell selbst: Ein schwacher Retriever liefert generische Antworten, egal wie gut das LLM ist.
Agentische, mehrschrittige Ausführung. Der Schritt über das Gespräch hinaus ist ein Assistent, der handelt: entwirft, Datensätze aktualisiert, Freigabeprozesse auslöst, Datenbanken abfragt, alles innerhalb eines einzigen Austauschs. Das beruht auf diszipliniertem Tool-Einsatz, und die Kriterien, die zählen, sind Zuverlässigkeit, Auditierbarkeit jeder Aktion und die Tiefe der nativen Integrationen.
Sicherheit, Compliance und Data Residency. Für regulierte Daten ist das genauso wichtig wie die Funktionalität. Datenisolation hält Ihre Inhalte aus gemeinsamem Training und aus anderen Mandanten heraus. Rollenbasierte Zugriffskontrolle beschränkt Antworten auf berechtigte Nutzer. Data Residency hält die Verarbeitung innerhalb der geforderten Region. On-Premise- oder Private-Cloud-Deployment, Audit-Logging und die Ausrichtung an Frameworks wie DSGVO, SOC 2 oder SR 11-7 für Modellrisiko sind in Banken, Versicherungen und im Gesundheitswesen Grundvoraussetzungen, keine Extras.
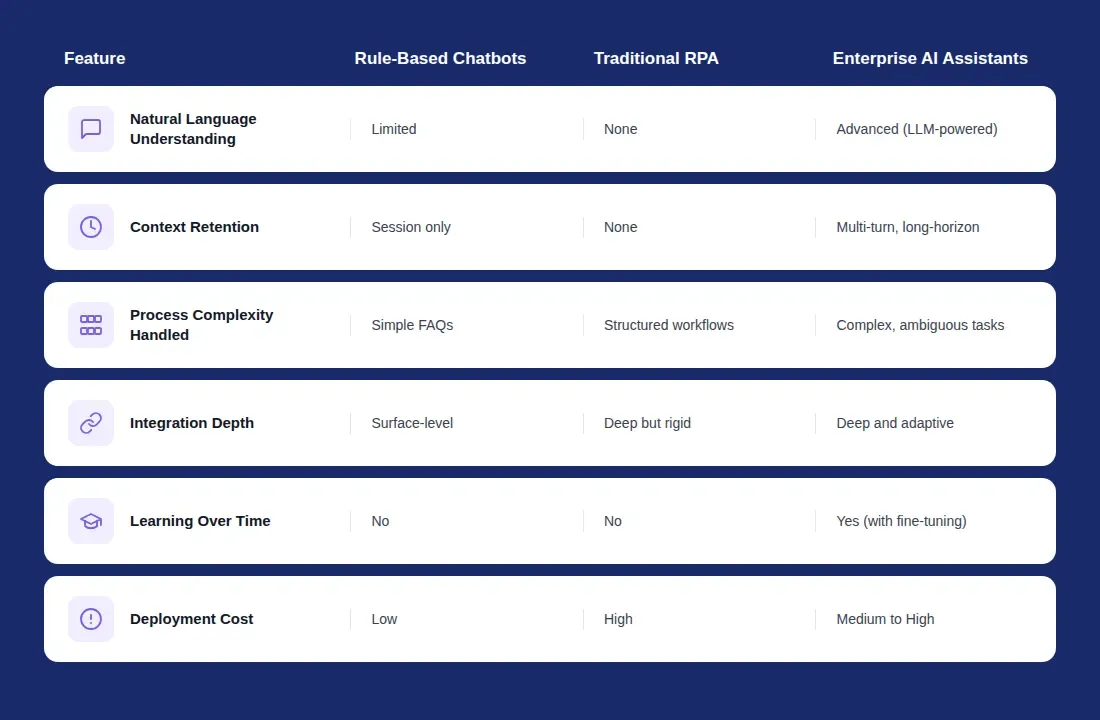
Ein Assistent funktioniert am besten als Koordinationsschicht über bestehenden Chatbots und RPA, die entscheidet, wann Automatisierung ausgelöst, wann an einen Menschen eskaliert und wann eine Anfrage im Gespräch gelöst wird, statt ein einzelnes Tool zu ersetzen. Und der größte Teil der Deployment-Kosten steckt in Integration und Change Management, nicht in der Plattform-Lizenz, was genau der Grund ist, warum das ausführende Team mehr zählt als das Emblem auf der Software.
Was brauchte UNIQA?
UNIQA hatte mit den operativen Schmerzen zu kämpfen, die für einen großen, regulierten Versicherer typisch sind. Seine Agenten und Berater arbeiteten gegen eine riesige, ständig aktualisierte Bibliothek aus Allgemeinen Versicherungsbedingungen (OWU-Dokumenten), Produkttarifen und internen Verfahren. Die schiere Menge machte einen schnellen, verlässlichen Zugriff mit herkömmlicher Suche nahezu unmöglich, und daraus erwuchsen vier kostspielige Probleme:
- Geringe Auffindbarkeit, sodass Agenten Mühe hatten, die richtige Klausel oder Bestimmung schnell zu finden.
- Hohe durchschnittliche Bearbeitungszeit (AHT), weil Berater tatsächlich Zeit damit verbrachten, Antworten manuell zu suchen.
- Inkonsistente Antworten über die Kanäle hinweg, wobei Callcenter, E-Mail-Team und Chatbot auf dieselbe Frage manchmal unterschiedliche Antworten gaben.
- Langsames, teures Onboarding, ohne effizienten Weg, neue Agenten auf ein komplexes Produktportfolio zu schulen.
Was hat unser Team gebaut?
Unser Team lieferte ein intelligentes Assistenten-Panel, direkt in die bestehende Oberfläche des Agenten eingebettet, aufgebaut auf einer RAG-Architektur mit PLLuM, einem für Polnisch optimierten Foundation-Modell. Das war eine bewusste Entscheidung: Generische mehrsprachige Modelle verlieren an Genauigkeit bei polnischer Versicherungssprache, und in einem regulierten Umfeld ist dieser Verlust nicht akzeptabel. Die Wahl spiegelt die Art von Entscheidung wider, die unsere Engineers routinemäßig treffen, das Modell zur Domäne passend wählen, statt zum größten Namen zu greifen.
Der Build löste alle vier Probleme auf einmal:
- Ein AI-Vorschlags-Panel liefert geprüfte, sofort einsetzbare Antworten während laufender Kundeninteraktionen, beseitigt manuelle Dokumentensuchen und drückt die AHT nach unten.
- Automatisierte Zusammenfassung verwandelt dichte OWU-Rechtsbestimmungen in klare, kundengerechte Sprache und senkt so Bearbeitungszeit und das Risiko von Fehlinterpretationen.
- Die Integration in die bestehenden CRM- und Callcenter-Plattformen schuf eine Single Source of Truth, sodass Antworten über jeden Kanal hinweg konsistent bleiben.
Für die Sicherheit wurde die Lösung On-Premise statt in einer Public Cloud deployt und erfüllte damit die Anforderungen an sensible Policen- und Kundendaten. Und die RAG-Architektur wurde auf strikte Halluzinationskontrolle konfiguriert, sodass jede Antwort in abgerufener Dokumentation verankert ist und nicht im Raten des Modells.
Welche Kompetenzen steckten dahinter?
Liest man den Build rückwärts, sieht man genau, was unser Team in ein reguliertes AI-Engagement einbringt:
- Arbeit mit einem Foundation-Modell in polnischer Sprache (PLLuM), wo Genauigkeit in polnischer Rechts- und Versicherungssprache nicht verhandelbar ist.
- RAG mit harter Halluzinationskontrolle, die Disziplin, die aus einem plausiblen Chatbot ein System macht, das Aufsichtsbehörden und Risikoverantwortliche freigeben.
- On-Premise-Delivery in einer regulierten Branche, was eine der häufigsten Beschaffungshürden aus dem Weg räumt, statt um sie herum zu argumentieren.
- Tiefe Integration in laufende CRM- und Contact-Center-Systeme, sodass der Assistent innerhalb bestehender Workflows agiert und nicht neben ihnen.
Wie hat das Team es geliefert?
Nichts davon kommt aus einem Tool, es kommt aus einem dedizierten Team mit der richtigen Seniorität, das diszipliniert und in Phasen arbeitet. Das Rollout wurde bewusst gestuft, um Risiko zu steuern und Ergebnisse zu belegen, bevor skaliert wird: die ersten zwei Wochen für Prozess-Audit und Discovery, Workflows mappen und die wirkungsvollen Startpunkte finden; Wochen drei bis sechs für Datenintegration, Aufbereitung der Wissensbasis und RAG-Infrastruktur; Wochen sieben und acht für Modellkalibrierung und einen kontrollierten Piloten mit ausgewählten Agenten; dann volles Deployment und KPI-Optimierung. Fokussiert starten, mit echten Nutzern validieren, dann skalieren, und die Adoption schrittweise aufbauen lassen, statt dem gesamten Agentennetz auf einen Schlag ein neues System vorzusetzen.
In UNIQAs eigenen Worten ist der Assistent „ein strategischer Schritt hin zu modernem Kundenservice”, ein Werkzeug, das Mitarbeitende in Echtzeit mit präzisem, geprüftem Wissen unterstützt, und vor allem eine spürbare Verbesserung der Versicherungsstandards, dort, wo genaue Informationen Kundenvertrauen aufbauen.
Was bedeutet das für regulierte Branchen?
Für Versicherer, Banken, Gesundheitsdienstleister und andere regulierte Organisationen macht das UNIQA-Engagement einen konkreten Punkt: domänenspezifische Sprachmodelle, striktes RAG-Grounding, sicheres Deployment und tiefe Integration liefern Ergebnisse, die generische AI-Tools nicht liefern können. Aber der tiefere Punkt ist, dass alle vier Ausführungsentscheidungen sind, getroffen von erfahrenen Menschen. Ein Assistent ist immer nur so gut wie das Team, das sein Retrieval designt, seine Grounding-Schwellen setzt und ihn in Ihre Systeme verdrahtet.
Genau hier formt AI auch das Team um, nicht das Angebot. Eine kleine, erfahrene Gruppe unserer Engineers, verstärkt durch AI-Tooling, das das Volumen übernimmt, liefert, was ein viel größeres klassisches Team liefern würde, und das schneller, weil die Menschen in der Schleife bereits wissen, welche Entscheidungen ein Audit überstehen.
Wie holen Sie sich dieses Team ins Haus?
Wenn Sie in Versicherung, Banking, Gesundheitswesen oder einer beliebigen regulierten Branche tätig sind und RAG- und LLM-Arbeit wollen, die die Compliance beim ersten Mal besteht, ist der schnellste Weg nicht, die Fähigkeit von Grund auf zusammenzubauen. Es ist, ein Team hinzuzuholen, das es bereits getan hat. Wir docken als dediziertes Team an, das einen Assistenten-Build End-to-End verantwortet, oder über Staff Augmentation, wenn Sie erfahrene RAG- und LLM-Engineers innerhalb Ihres bestehenden Teams brauchen.
Der UNIQA-Fall ist keine Behauptung über ein Produkt. Er ist ein Beleg dafür, was unsere Leute geliefert haben. Das ist die Fähigkeit, die auf dem Tisch liegt.
FAQ
Wie verhindert ein Enterprise-AI-Assistent Halluzinationen und bleibt faktisch korrekt? Die primäre Methode ist Retrieval-Augmented Generation: Das System ruft relevante Dokumente aus einer geprüften Wissensbasis ab und nutzt sie als Grundlage für seine Antwort, statt sich auf das Vortraining des Modells zu verlassen. Wirksame Systeme ergänzen Konfidenzschwellen, sodass der Assistent Unsicherheit signalisiert oder an einen Menschen eskaliert, wenn der abgerufene Inhalt eine Antwort nicht klar stützt. In unserem UNIQA-Build haben wir strikte RAG-Kontrollen eingesetzt, um die Genauigkeitsstandards zu erfüllen, die die Versicherung verlangt, wo eine falsche Antwort finanzielle und regulatorische Folgen hat.
Wie sieht ein realistischer Umsetzungszeitplan aus? Das hängt von der Komplexität des Use Cases, dem Zustand Ihrer Wissensbestände und dem Integrationsbedarf ab. Ein fokussiertes Deployment für eine Abteilung mit einer gut organisierten Wissensbasis kann in sechs bis acht Wochen einen Piloten erreichen, wie die UNIQA-Roadmap gezeigt hat. Breitere Rollouts über mehrere Funktionen hinweg laufen typischerweise drei bis sechs Monate von der Definition bis zur Produktion. Nach unserer Erfahrung ist der beste Einzelindikator für den Zeitplan, wie bereit die Wissensbasis ist, planen Sie also neben der technischen Arbeit Zeit für Change Management und Adoption ein.
Wie werden sensible Daten und Compliance gehandhabt? Durch Mandantenisolation, die Ihre Daten getrennt und aus gemeinsamem Training heraushält, rollenbasierte Zugriffskontrolle, die Ihre bestehenden Berechtigungen abbildet, und Audit-Logging von Anfragen und Antworten. Wo die Data Residency strikt ist, hält ein On-Premise- oder Private-Cloud-Deployment die Verarbeitung innerhalb der geforderten Grenzen, genau der Weg, den wir bei UNIQA gegangen sind. In regulierten Branchen wird das durch vertragliche Absicherung wie DSGVO-Auftragsverarbeitungsverträge und SOC-2-Zertifizierung verstärkt.
Wie sollten wir den ROI messen? Nutzen Sie bestehende operative Kennzahlen, keine geschätzten Produktivitätsgewinne. In Contact Centern verfolgen Sie die durchschnittliche Bearbeitungszeit, die Erstlösungsquote und die ohne Eskalation gelösten Anfragen. Im Wissensmanagement vergleichen Sie die Zeit bis zur Antwort vorher und nachher und achten auf weniger wiederholte Rückfragen an Experten. Setzen Sie Baselines vor dem Start, prüfen Sie nach 30, 60 und 90 Tagen und beobachten Sie die Adoption, denn ein ungenutzter Assistent liefert keine Rendite, unabhängig von der technischen Genauigkeit.
Holen Sie sich ein Team von Experten, verstärkt durch AI → /services/team-augmentation